摘要: 大语言模型(LLM)虽然强大,但“幻觉”问题始终是落地的绊脚石。本文将带你了解 RAG(检索增强生成)技术,看它如何通过“开卷考试”的方式,让 AI 回答得更准确、更可信。
正文:
如果你曾尝试将 ChatGPT 或国内的大模型应用到企业内部业务中,你一定遇到过一个令人头疼的问题:大模型的“幻觉”(Hallucination)。当你问它一个公司内部特有的专有名词,或者最新的行业数据时,它往往会凭借强大的语言组织能力,给你编造一个看似合理,实则完全错误的答案。
那么,如何解决这个问题?过去,人们首先想到的是“微调(Fine-tuning)”。但微调不仅成本高昂,且无法实时更新知识。如今,整个 AI 届给出的标准答案是:RAG(Retrieval-Augmented Generation,检索增强生成)。
什么是 RAG?
RAG 的概念最早由 Meta(前 Facebook)的 AI 研究人员提出。顾名思义,它将“信息检索(Retrieval)”与“文本生成(Generation)”结合在了一起。
为了便于理解,我们可以打个比方:
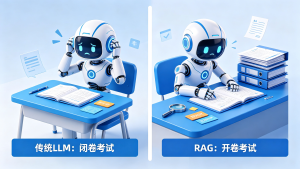
传统的 LLM 就像是一个**“闭卷考试”**的学生。它的知识全部来自于考试前(预训练阶段)背诵的书本内容。如果考卷上出现了它没背过的最新知识,它为了拿分,就只能凭语感去瞎编。
而 RAG 则是赋予了这位学生**“开卷考试”**的权力。
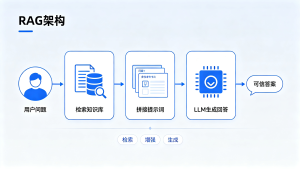
当用户提出一个问题时,RAG 系统并不会立刻让 LLM 回答。它的工作流程如下:
- 检索(Retrieve): 系统首先将用户的问题转化为搜索词,进入企业自己的“外部知识库”中,寻找与该问题最相关的几篇文档或段落。
- 增强(Augment): 系统将检索到的这些相关文档,连同用户最开始提的问题,组合拼接到一起,形成一个包含背景上下文的长提示词(Prompt)。
- 生成(Generate): 将这个庞大的 Prompt 喂给大模型。大模型在阅读了你提供的“参考资料”后,再进行总结和回答。
RAG 为什么比微调更好?
很多人会问,我为什么不直接把企业文档微调进大模型里?RAG 相比微调,有三大压倒性的优势:
- 知识实时更新,无重新训练成本: 你的公司今天发布了新产品,你只需要把产品手册扔进 RAG 的知识库里,下一秒 AI 就能准确回答。如果是微调,你不得不重新跑一遍耗时费力的训练流程。
- 数据隐私与权限控制: 在 RAG 架构中,知识库可以与大模型分离。你可以针对不同的员工,在“检索”阶段进行权限控制。普通员工检索不到机密财务文档,大模型自然也就不会把机密信息生成出来。
- 答案可溯源(引证): 既然大模型是根据检索到的文档总结的,那么 RAG 系统在输出答案时,可以轻松附上“参考来源(Source)”。用户如果怀疑答案的准确性,可以直接点击链接查看原文档,极大地增强了系统的可信度。
结语
RAG 技术就像是给大语言模型外挂了一个“超级U盘”。大模型负责发挥其强大的阅读理解和逻辑推理能力,而外挂知识库则提供精准、实时的事实依据。在企业级 AI 应用落地的今天,RAG 已经成为了不可或缺的核心基础设施。
在下一篇文章中,我们将拆解 RAG 的黑盒,深入探讨它是如何在上百万份文档中,瞬间找到与你问题最相关的那一段的——这一切,都要归功于神奇的“向量数据库”。
