摘要: RAG 系统如何在上百万字的企业文档中“秒查”出相关内容?这就不得不提 RAG 架构中的两大核心幕后功臣:文本向量化(Embedding)与向量数据库(Vector Database)。
正文:
在前一篇文章中,我们介绍了 RAG(检索增强生成)的工作原理。其中最关键的一步,就是如何从海量的企业知识库中,把与用户提问最相关的文档“找出来”。
如果你使用传统的 MySQL 或者 ElasticSearch,你只能进行“关键词匹配”。比如用户搜“请假流程”,如果文档里写的是“休假制度”,传统搜索就大概率找不到。但在 AI 时代,RAG 需要的是**“语义检索(Semantic Search)”**。
实现语义检索的核心魔法,就是 Embedding 和向量数据库。
万物皆可向量:什么是 Embedding?
计算机是不认识人类文字的,它只认识数字。Embedding(嵌入/向量化),就是将人类的词语、句子甚至整篇文章,映射(翻译)成一串多维的数字数组。
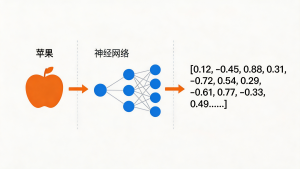
你可以把这个多维数字数组想象成一个在超高维空间(比如 1536 维)里的“坐标点”。
- 在语义上越相近的词或句子,它们在这个高维空间里的距离就越近。
- 例如:“苹果”和“橘子”这两个坐标点的距离很近(都是水果);而“苹果”和“汽车”的距离就很远。
当我们将企业里的几万份文档全部扔给 Embedding 模型(如 OpenAI 的 text-embedding-ada-002 或开源的 BGE-M3)后,所有的文档都被转化成了无数个高维空间里的坐标点。
向量数据库:高维空间的“导航仪”
当几万份、几十万份文档变成向量后,我们不可能把它们放在普通的文本文件里,我们需要一种专门为了存储和极速查找这些高维坐标点而设计的数据库——这就是向量数据库(Vector Database)。
目前市面上主流的向量数据库有开源的 Milvus、Qdrant、Chroma,以及托管服务 Pinecone 等。
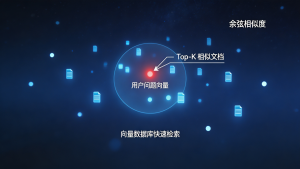
[图片插入建议2:一张三维空间图,空间中散布着许多点,一个表示 User Query 的红点正在寻找它周围最近的几个蓝点(文档片段),旁边标注“Cosine Similarity(余弦相似度)”。]
在 RAG 系统中,检索的本质发生了变化:
- 用户提出问题:“公司年假怎么休?”
- 系统立刻用同一个 Embedding 模型,将用户的提问也变成一个多维向量(坐标点)。
- 系统将这个坐标点扔进向量数据库中。
- 向量数据库使用专门的算法(如近似最近邻 ANN,计算余弦相似度等),在极短的时间内,找出空间中距离用户提问最近的 Top K(比如 5 个)坐标点。
- 系统提取出这 5 个点对应的原始文本,这就是大模型需要的“参考资料”。
因为“公司年假怎么休”和“员工休假制度指南”在语义上是高度相关的,所以它们的向量距离很近。即使关键词完全不同,向量数据库依然能精准地把正确的文档找出来。
混合检索:现代 RAG 的标配
虽然向量检索非常强大,但在实际业务中,它并不是万能的。比如当用户搜索特定的员工工号、特定的商品型号(如“iPhone 15 Pro Max 256G”)时,向量检索往往会失效,因为它更擅长理解“意图”,而不是“精准匹配”。
因此,目前工业级 RAG 系统通常采用**“混合检索(Hybrid Search)”方案:
将传统的关键词倒排索引检索(如 BM25 算法)与向量语义检索**结合起来。各取所需,最后对两边的搜索结果进行融合,从而达到最高的检索召回率。
结语
Embedding 赋予了文本以空间的维度,而向量数据库则提供了在这个空间中极速穿梭的能力。这两者的结合,构成了 RAG 系统的坚实底座。但在实际应用中,你可能会发现找出来的文档片段太长或者太碎,导致大模型依然回答不好。
下一篇文章,我们将探讨 RAG 的进阶优化策略:文档切块(Chunking)与重排(Reranking)。
