摘要: 为什么你的 RAG 系统总是找不准信息?大模型为什么会“迷失在上下文”中?本文将为你揭开构建工业级 RAG 系统的两大优化利器:Chunking(文本切块)与 Rerank(重排)。
正文:
当你刚刚搭好一个基础的 RAG(检索增强生成)系统,兴致勃勃地投入使用时,通常会遭遇现实的毒打:系统不仅回答慢,而且经常在关键信息上“翻车”。
这并不是大模型不够聪明,而是你喂给它的“饲料”出了问题。要打造一个好用的 RAG 系统,60% 的精力都需要花在数据预处理和检索优化上。今天我们要讲的,就是 RAG 调优中最重要的两步:文档切块(Chunking)与结果重排(Reranking)。
为什么要切块(Chunking)?
假设你的知识库里有一份 10 万字的《员工手册》。如果不做处理直接向量化,系统根本无法定位细节;此外,大模型的上下文窗口(Context Window)是有限的,你不可能每次提问都把整本书塞进 Prompt 里。
因此,我们需要在存入向量数据库之前,把长文档“切碎”。

主流的切块策略有哪些?
- 按字符/Token 长度切分(固定大小): 最简单粗暴的方法。比如每 500 个 Token 切一块。但缺点是容易把一句完整的话腰斩,导致语义丢失。
- 设置重叠区(Overlap): 为了解决上述腰斩问题,切块时保留一定的交集。比如块大小设为 500,重叠区设为 50。这样块 1 的结尾和块 2 的开头是重复的,保证了上下文的连贯性。
- 按文档结构切分(语义切块): 这是目前推荐的高级做法。使用 Markdown 解析器,按照 H1、H2、H3 标题,或者按自然段落进行切块。这种切法最大程度保留了信息原有的逻辑完整性。
切块大小的选择是一门艺术:块太小(如 50 词),大模型缺乏足够的上下文来理解;块太大(如 2000 词),检索的精准度会下降,且会引入大量噪音,导致大模型产生“迷失在中间(Lost in the middle)”的现象——即大模型容易记住开头和结尾的信息,而忽略中间的重点。
重排(Rerank):去芜存菁的最后一道防线
当向量数据库根据相似度找出了 Top 10 个相关片段后,就可以直接喂给大模型了吗?千万别!
向量数据库虽然检索速度极快,但它的计算方式(余弦相似度)相对粗糙。很多时候,排在第一位的片段,反而不是最能回答用户问题的。如果把 10 个片段都扔给大模型,不仅消耗巨额的 Token 费用,大量无关的噪音还会严重干扰大模型的判断。
这时候,我们需要引入重排模型(Reranker / Cross-Encoder)。
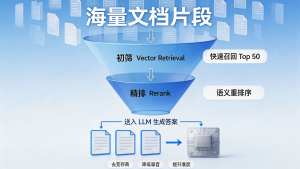
[图片插入建议2:一个漏斗图。最上方是海量文档;中间层标为“初筛 (Vector Retrieval)”,选出 50 个片段;下层标为“精排 (Rerank)”,选出最精准的 5 个片段输入给大模型。]
Rerank 的工作机制:
重排模型(如 BGE-Reranker 或 Cohere Rerank)是一种专门训练来判断“问题”和“文档”是否匹配的模型。
- 初筛(召回): 向量数据库先快速、粗略地捞出 Top 50 篇疑似相关的文档片段。
- 精排(排序): 将用户的 Query 和这 50 个片段,一对一地输入给 Rerank 模型。Rerank 模型会进行极其细致的语义级交互计算,打出一个精确的匹配分数。
- 截断: 根据 Rerank 的打分重新排序,只取打分最高的最核心的 3 到 5 个片段,最终送给大模型生成答案。
这就像公司招聘,向量数据库是 HR 浏览简历初步筛选(快但粗略),Reranker 则是部门主管亲自进行深度面试(慢但精准)。
结语
合理的 Chunking 策略决定了你知识库的数据质量,而引入 Rerank 机制则大幅提升了检索的准度与大模型回答的准度。掌握了这两步,你的 RAG 系统就已经超越了 80% 的新手玩具,达到了可以落地的工业级水准。
但在不断优化的过程中,我们如何客观地判断我们的修改是变好了还是变差了?
下一篇,我们将介绍 RAG 系统的自动化评估体系。
