摘要: “感觉回答得还行”不是一个科学的工程指标。在构建 RAG 系统时,我们如何定量地评估其性能?本文将深入解析 RAG 的核心评估三要素,并介绍主流的评估框架 RAGAS。
正文:
传统的软件工程有明确的单元测试和覆盖率,传统的机器学习有准确率(Accuracy)和召回率(Recall)。但在大模型时代,当你调整了 Chunking 的大小,或者换了一个新的大模型后,你怎么知道你的 RAG 系统到底是变聪明了,还是变笨了?
仅靠肉眼看几条回答(“看着还行”)是极其不科学且无法扩展的。“无法度量,就无法优化”。因此,建立一套自动化、标准化的 RAG 评估体系至关重要。
RAG 评估的“铁三角”
评估一个 RAG 系统的表现,我们需要将其拆解开来。因为 RAG 包含“检索”和“生成”两个阶段,任何一个阶段掉链子,最终的回答都会出错。业界目前普遍公认的 RAG 评估核心三要素如下:
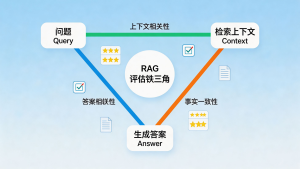
1. 上下文相关性 (Context Relevance):评估“检索”阶段
- 衡量什么: 向量数据库找出来的那几段文档,真的包含回答问题所需的信息吗?还是找了一堆废话?
- 高分表现: 找出来的文档极其精准,没有夹杂无关的噪音。
2. 事实一致性/忠实度 (Groundedness / Faithfulness):评估“生成”阶段的幻觉
- 衡量什么: 大模型生成的答案,是不是严格基于检索到的上下文?它有没有自己添油加醋,或者编造上下文里没有的信息?
- 高分表现: 答案中的每一句话,都能在检索到的参考文档中找到对应的句子,绝不胡编乱造。
3. 答案相关性 (Answer Relevance):评估整体用户体验
- 衡量什么: 大模型最终的回答,是不是直接回答了用户最初的问题?有没有答非所问、避重就轻?
- 高分表现: 切中肯綮,直接解决用户的痛点。
LLM-as-a-Judge:用魔法打败魔法
明确了指标后,难道需要雇佣几十个人工每天去打分吗?显然不现实。目前业界最流行的做法是 “LLM-as-a-Judge(用大模型做裁判)”。
我们编写极其严谨的提示词,让一个更强大的大模型(如 GPT-4)来扮演裁判。把测试集的问题、检索出的上下文、测试 RAG 系统生成的答案全部给到裁判模型,让它按照上述的“铁三角”指标,分别打出 0-10 分,并给出扣分理由。
介绍 RAGAS 评估框架
为了规范这一过程,开源社区诞生了优秀的评估框架,其中最著名的就是 RAGAS (Retrieval Augmented Generation Assessment),类似的还有 TruLens。
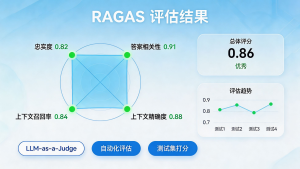
使用 RAGAS,你只需要准备一个测试数据集(包含一定量的问题和标准答案),RAGAS 的 Python 库会自动调用裁判大模型,帮你计算出以下核心指标的得分(0 到 1 之间):
- Faithfulness(忠实度)
- Answer Relevancy(答案相关性)
- Context Precision(上下文精确度:是否只召回了有用的块,去除了噪音)
- Context Recall(上下文召回率:是否找全了所有必需的信息,没有遗漏)
每次你修改了向量数据库配置、更改了 Prompt,只需要运行一遍 RAGAS 测试脚本。如果整体均分从 0.7 提升到了 0.85,你就可以放心地把这次更新部署到生产环境了。
结语
构建一套自动化的 RAG 评估流水线,是从“Demo 玩具”走向“企业级工程产品”的必经之路。
到目前为止,我们讨论的依然是传统的 RAG 架构(检索 -> 拼接 -> 回答)。但在实际场景中,用户的需求远比这复杂。
本系列最后一篇,我们将展望 RAG 技术的未来:Agentic RAG(基于智能体的检索生成)。
